模型与提供商
TIP
提供商负责「怎么连上模型服务」,模型负责「这次用哪一个」。两者分开后,换模型不用重填密钥,换服务也不用改对话设置。
ChatLuna 不内置任何模型,也不限定服务商。你可以同时接入多个提供商,再按聊天场景、角色或后台任务选用不同的模型。
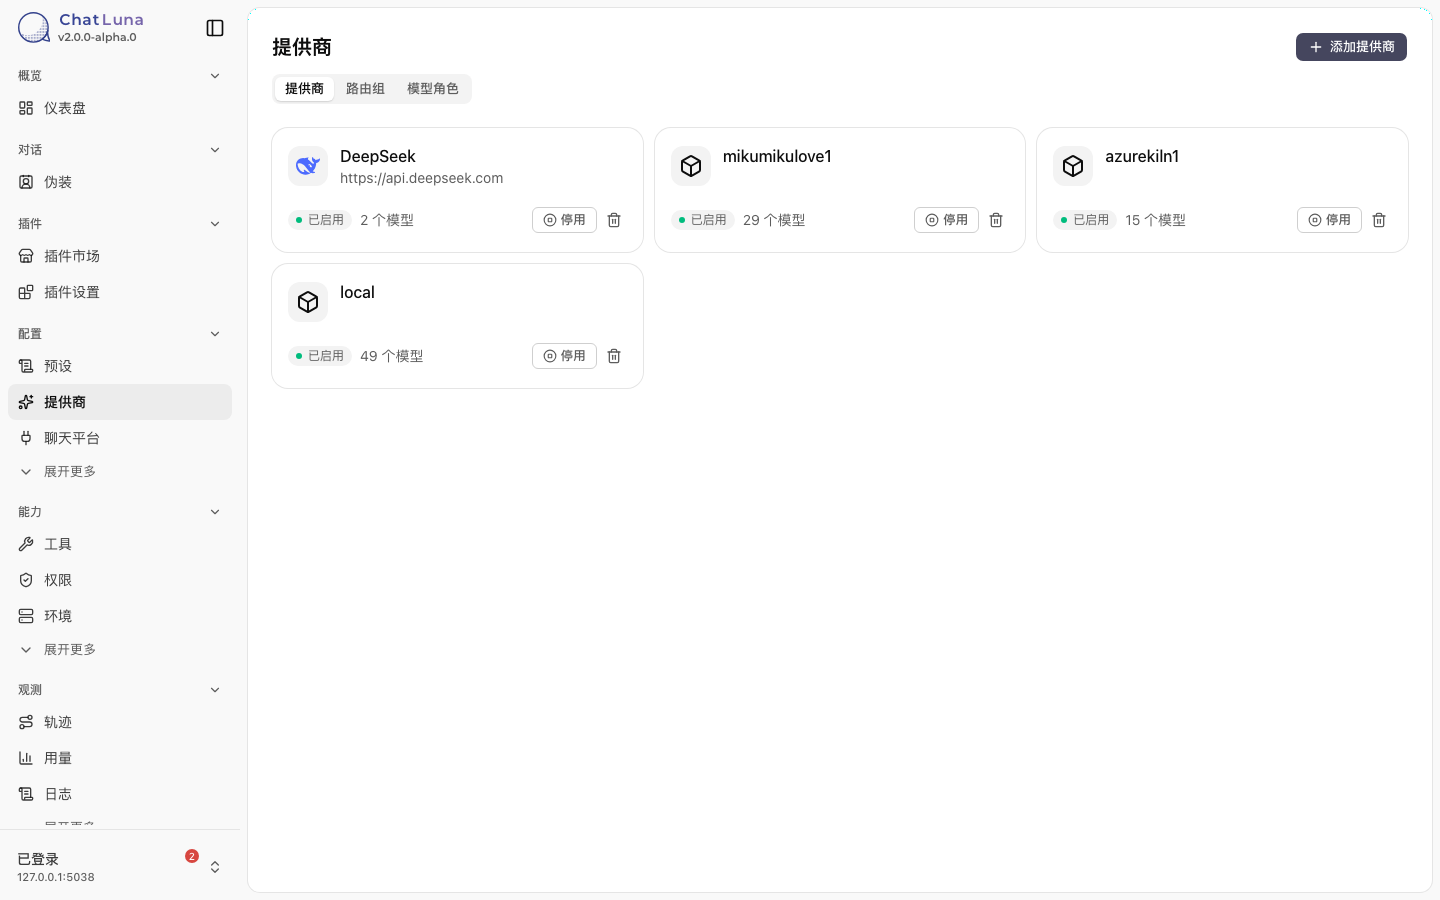
提供商
提供商(Provider)是一次具体的服务连接,由端点、凭据和模型清单组成。同一个服务商可以接入多次,例如两个不同的 OpenAI 账号只需使用不同的实例 ID。
常见类型:
- 官方服务:OpenAI、Anthropic、Google、DeepSeek、阿里云等。
- 聚合网关:OpenRouter、Vercel AI Gateway 等,一个账号调用多家模型。
- 云厂商托管:Azure OpenAI、Google Vertex AI、Amazon Bedrock 等。
- 兼容端点:OpenAI 兼容、Gemini 兼容、Claude 兼容,适用于中转、自建代理和本地部署。
- 复合路由:一个实例下挂多条路由,把不同请求分流到不同后端。
- Mock:本地模拟模型,用于测试和演示,不发起真实请求。
添加提供商
前往「配置 → 提供商」页面,点击「添加提供商」,选择类型后填写:
- 名称 / ID:实例的唯一标识。
- 端点地址:基础 URL,兼容端点通常需要以
/v1结尾。 - API 密钥:直接填写或使用凭据引用。
- 模型清单:不支持自动获取时需要手动填写模型 ID。
- 额外参数:云厂商托管服务通常还需要区域、项目 ID 或资源名称。
建议先点击「测试连接」,确认端点可达、密钥有效、模型列表可以获取后再保存。
凭据与多密钥
- 直接填写:密钥保存在实例配置中,适合本地调试。
- 凭据引用:配置中只记录凭据名称,密钥存放在凭据库中,推荐在多人协作或生产环境使用。
一个密钥字段可以填写多个密钥,用英文逗号分隔。遇到限流或密钥失效时会按顺序轮换,全部失败后才报错。
WARNING
不要把含明文密钥的截图、日志或配置文件发到公开场合。导出配置请他人协助前,先确认里面没有明文密钥。
模型
每个模型隶属于一个提供商实例,包含:
- 模型 ID:服务端识别的标识。
- 显示名称:界面中展示的名称。
- 能力:输入输出格式(文本、图片、音频、视频、文件),以及是否支持工具调用、结构化输出和推理。
- 上下文窗口:单次请求的最大 token 数。
- 价格:输入、输出和缓存读写的单价,用于估算成本。
- 推理档位:支持思考的模型可选的推理深度。
模型目录可以由插件自动获取,也可以手动维护。自动获取的信息有误时(例如识图模型被标为不支持图片),在模型详情页手动修改即可。
模型地址
系统统一用 提供商实例 ID:模型 ID 定位模型,例如 openai:gpt-4o-mini。这种格式出现在场景规则的「基本 → 模型」、聊天窗口的模型选择器、模型角色配置以及各类后台任务配置中。
冒号前是实例 ID,不是显示名称。修改实例 ID 后,引用旧 ID 的配置不会自动更新,需要手动重新选择。
模型角色
判定、记忆提取、标题生成等后台任务如果都交给主模型,既慢又贵。因此系统预设了四个模型角色:
- 小模型:判定、信息提取、摘要、生成标题等轻量任务。
- 中模型:通用子代理的默认模型,以及较复杂的规划。
- 大模型:需要高质量生成和复杂推理的任务。
- 决策模型:核心行为裁决,例如是否回复、高危操作是否允许。
在「配置 → 提供商」的「模型角色」标签页为各角色选择模型,全局生效。未绑定时,常规角色按「大模型 → 中模型 → 小模型 → 会话主模型」的顺序回退,决策模型回退到中模型。所以只配置一个主模型,后台任务也能运行。
视觉与多模态
系统根据目标模型的能力处理富媒体:
- 图片:模型不支持视觉时,图片会被替换为占位提示和文字描述。
- 音视频与文件:模型不支持时只保留链接和元信息。
- 工具调用:只有声明支持工具调用的模型才能使用工具。
目录中未登记的新模型会按标准格式收到富媒体内容,能否处理取决于服务端。机器人看不到图片时,先检查模型详情页的视觉能力是否勾选。
选模型的几种方式
多处配置同时存在时,按以下优先级从高到低决定:
- 单次调用显式指定(指令或脚本中临时指定)。
- 会话选择(聊天窗口的模型切换器或会话设置)。
- 场景规则。
- 引擎默认。
- 全局默认。
推理档位
- 低:响应快、消耗少,适合简单问题。
- 中:适合大多数日常任务。
- 高:多步推导,耗时更长、消耗更多,适合复杂分析和代码难题。
- 关闭:直接输出答案。
可选档位取决于模型。模型不支持推理时,档位设置会被忽略并在日志中记录,不影响回复。
运行时增强
在提供商连接之上,还可以按需启用:
- 重试:网络波动、限流或超时时按退避延迟重试。
- 回退:主模型持续报错时切换到备用模型。
- 缓存:复用完全相同请求的结果。
- 预算:按天、月或会话设置开销上限,超额时拒绝或降级。
- 账本:记录每次调用的 token 和成本。
- 降级:模型缺少某项能力时使用兼容方案。
- 分组:把多个提供商或模型组合成一个入口,按轮询或负载分流。
这些功能默认不会全部开启。长期运行的实例建议至少开启「重试」和「账本」。
首次配置
首次登录控制台时会弹出设置向导:选择提供商类型 → 填写密钥和端点并测试连接 → 选择默认模型 → 提交。密钥保存到凭据库,连接测试通过后实例才会进入「就绪」状态。
跳过向导后,可以随时在「配置 → 提供商」页面手动添加。没有 WebUI 的环境也可以通过配置文件预设提供商和默认模型。
推荐配置
| 场景 | 建议 |
|---|---|
| 个人使用 | 接入一家主流提供商,选一个性价比高的模型作为主模型;小模型和决策模型绑定同一家的经济型模型;开启重试和账本 |
| 多服务商 | 日常对话用响应快的主力模型;后台任务在「模型角色」中绑定便宜的轻量模型;含图片的会话用规则路由到擅长多模态的提供商 |
| 本地 / 自托管 | 用「OpenAI 兼容」连接 Ollama、LocalAI 或 vLLM 并手动填写模型 ID;关闭频繁重试和自动回退,避免本地服务过载;上下文窗口较小时调低压缩阈值 |
| 多群不同模型 | 全局默认用经济型模型,只在重点群的场景规则中覆盖为高性能模型 |
常见问题
添加提供商时连接失败:检查端点、密钥和代理。兼容端点确认末尾有 /v1 之类的版本路径;云厂商托管服务检查区域、项目 ID 等字段。
模型列表为空:部分中转或本地端点不支持自动获取,在「模型清单」中手动填写,大小写和版本后缀要完全一致。
回复报错「模型不存在」:检查模型地址冒号左侧是否为实例 ID。修改过实例 ID 时需要重新选择模型。
无法识别图片:检查模型详情页是否勾选了视觉能力,以及场景规则中的图片设置。
后台任务用了高成本模型:小模型或决策模型未绑定时会回退到会话主模型。在「模型角色」中明确绑定轻量模型。
切换模型后缓存未命中:模型标识是缓存键的一部分,频繁切换会让缓存失效。尽量固定一个主模型。
